之前很火的牛来(Ox)模型终于露出了真面目,就和之前猜测的一样,是智谱的模型。据说这个模型很小,所以能如此大量的提供给用户免费试用,并且会放出权重。
当然也有人在说智谱一边限制付费用户的使用量,一边给全球用户免费发放算力,这也太说不过去了吧?
据说这个模型价格可能会比 DeepSeek V4 Flash 还要便宜。这一点还得到时候看。不过我是没有买智谱的 Coding Plan 的,他们家价格实在是太贵了!
预计之后会有很多白嫖信息,到时候我会发布的。
不知道梁圣会不会把 DeepSeek 的价格再降下来,毕竟现在真的好贵好贵,我已经用不起了。
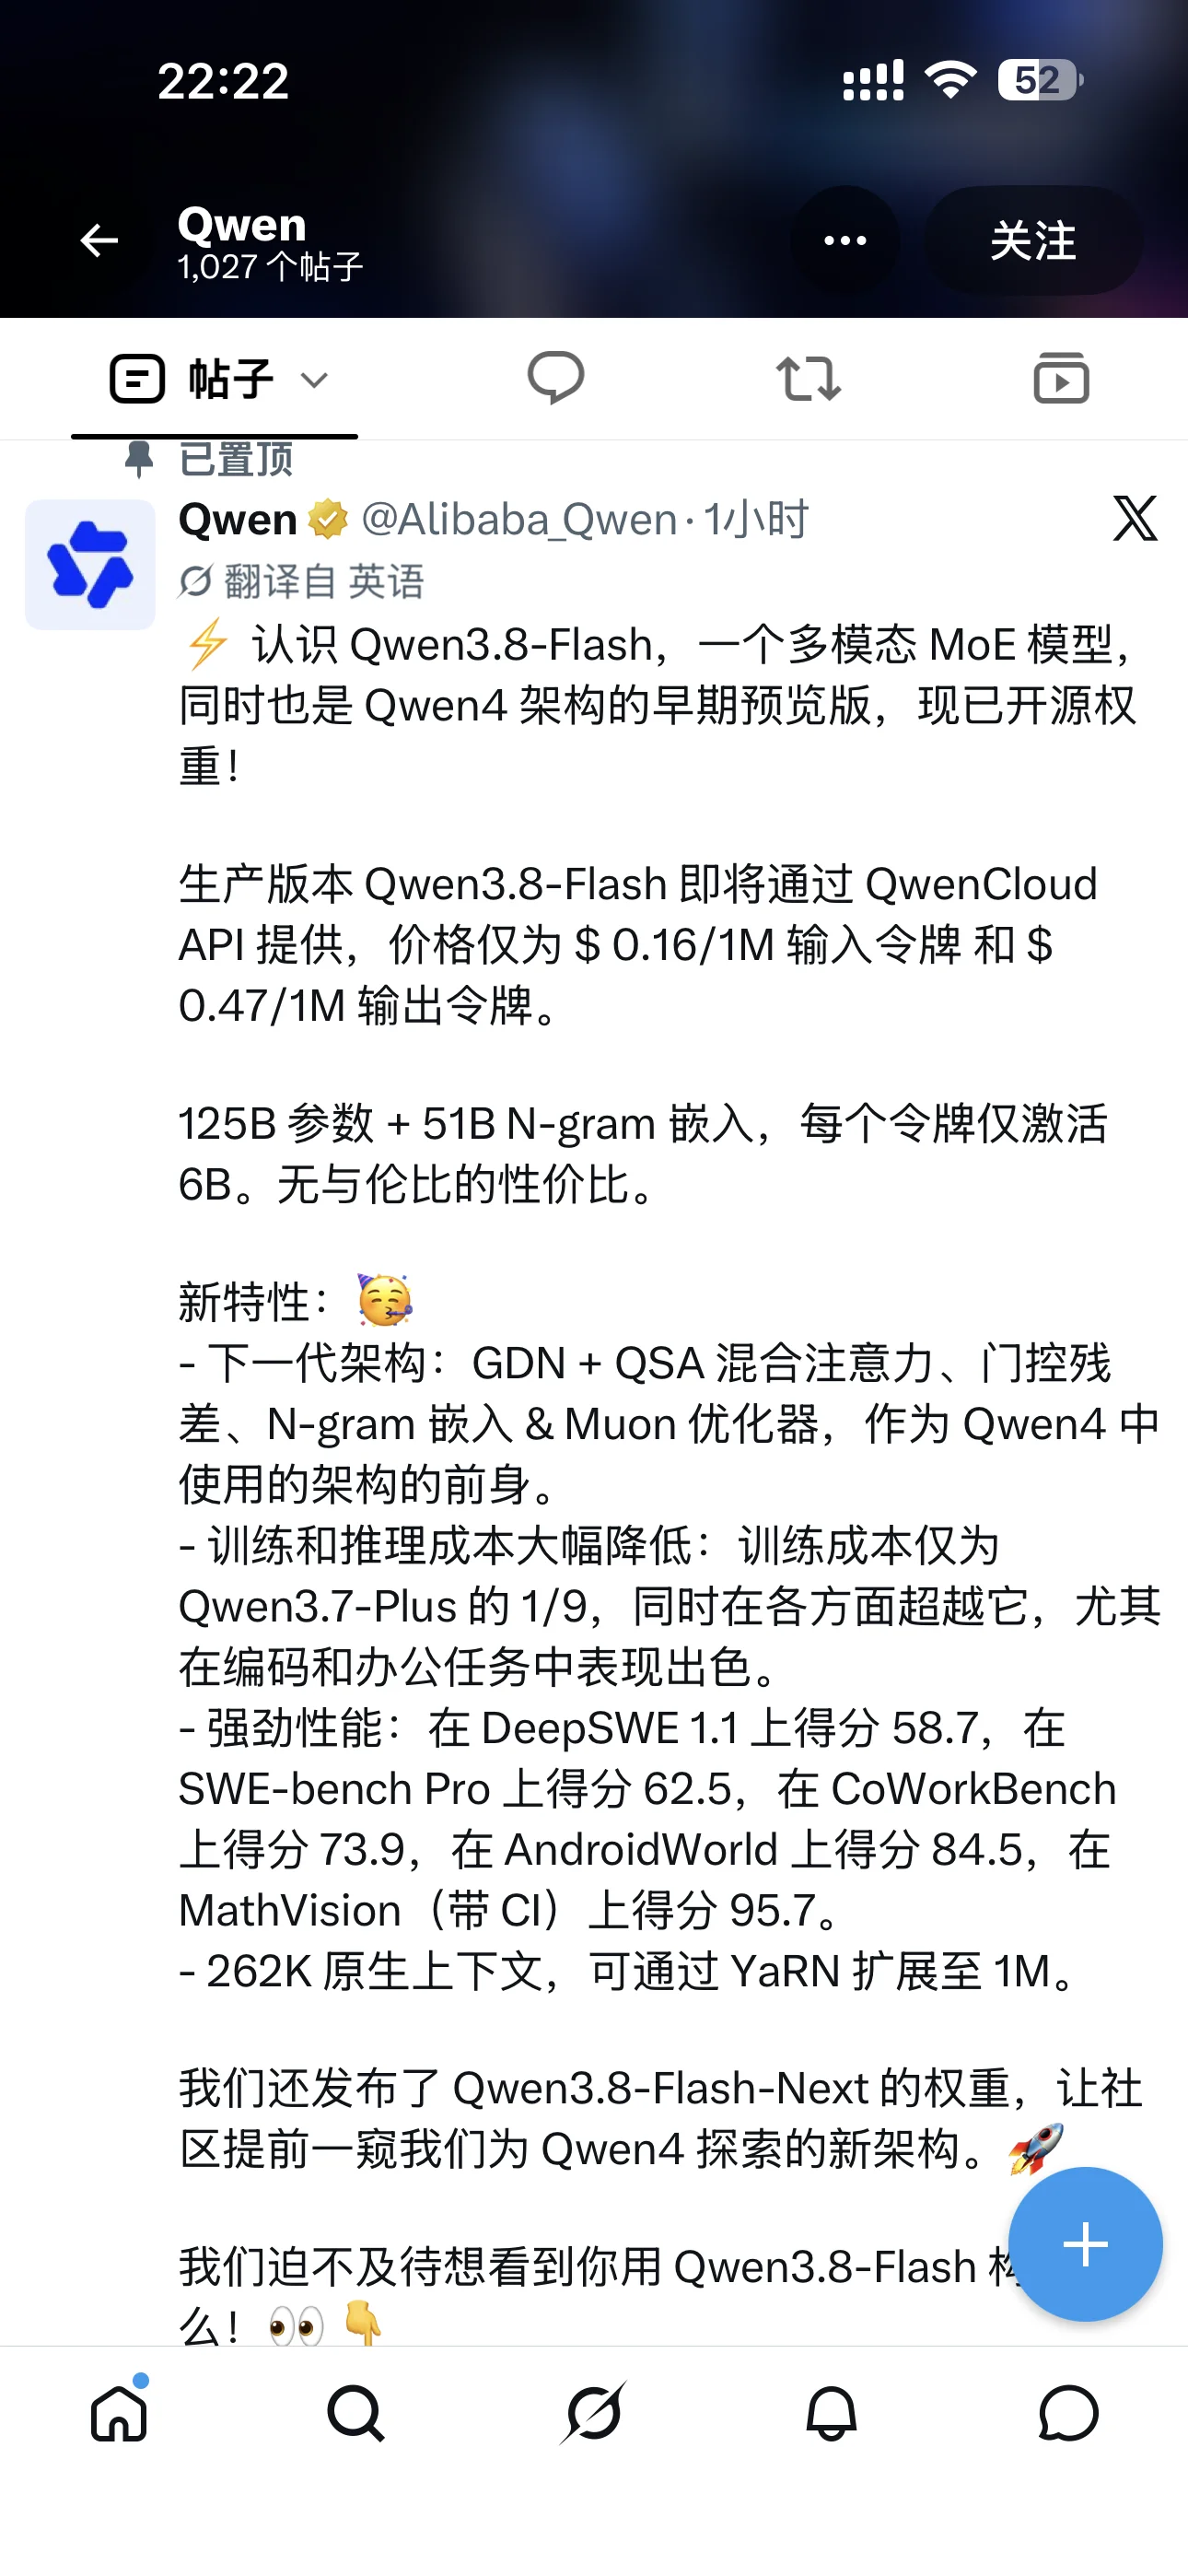
但与此同时,阿里千问进行了一次狙击,发布了他们的 3.8 Flash。从测评数据上看起来很不错。当然我也不知道真的假的,这个东西毕竟要用了以后才知道。
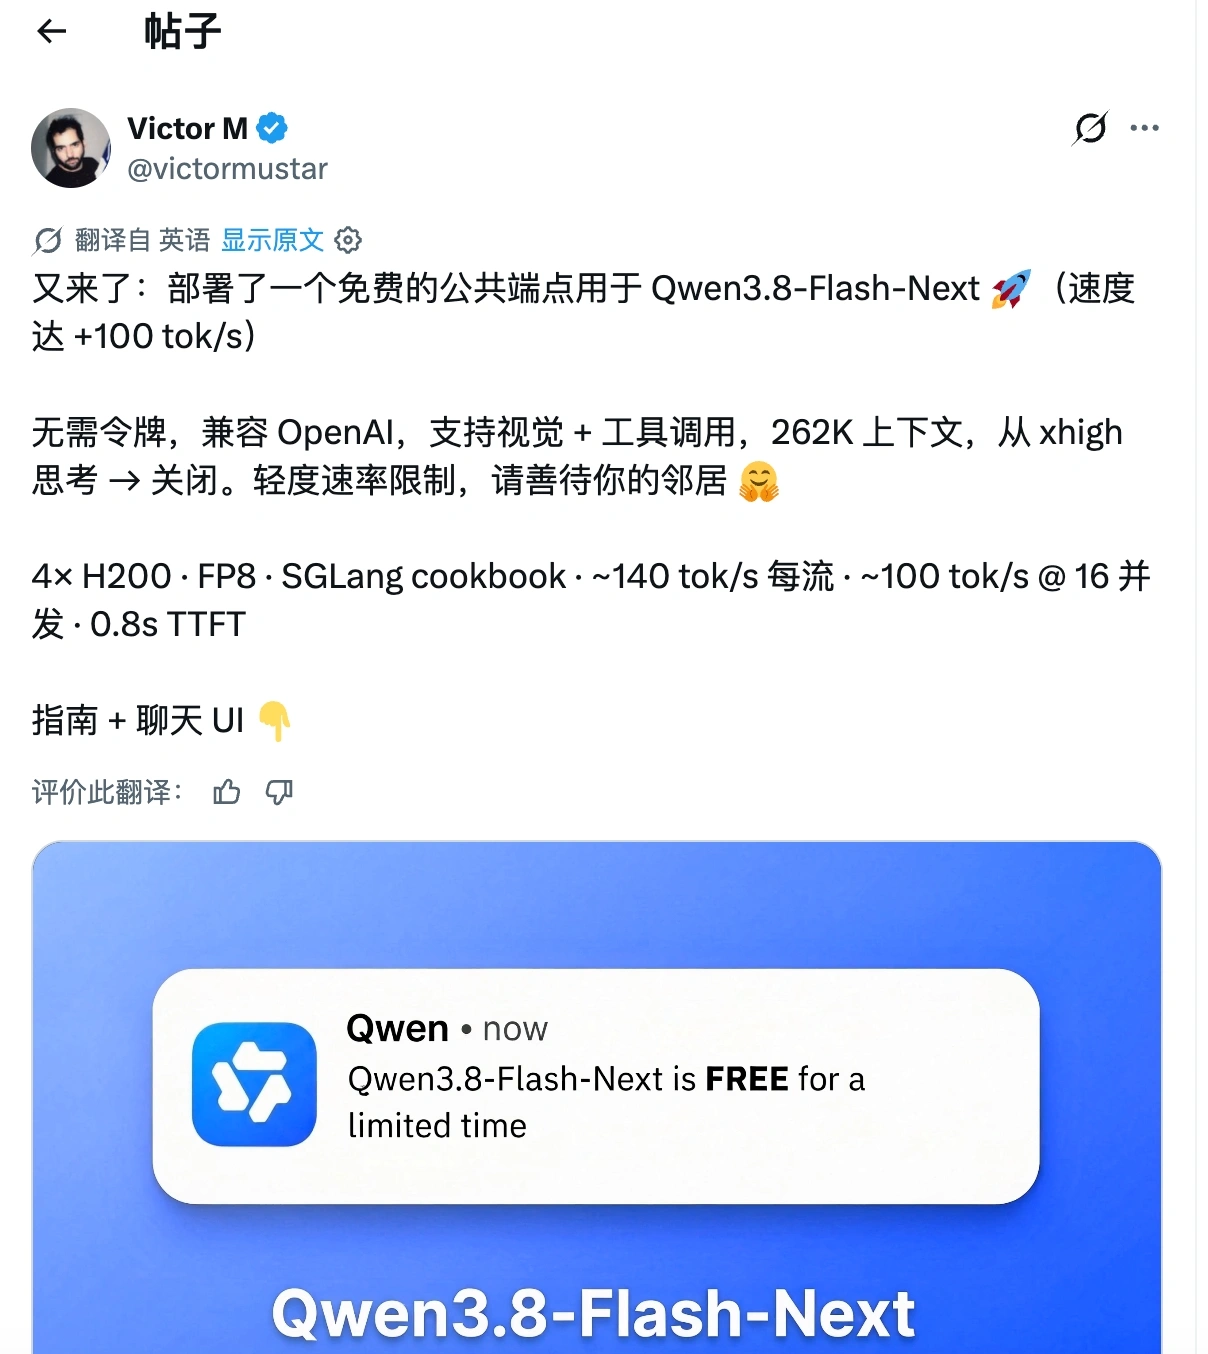
我随便逛了逛,直接就发现了一家可以免费提供,并且不需要你使用任何 API 的公共端点。不用申请,直接使用,没有比这更爽的了。
下面就来介绍一下具体应该怎么使用。
Hugging Face(Victor Mustar)公共推理端点
Hugging Face 产品负责人 Victor 部署在 AWS 上的免费公共端点(4× H200 · FP8 · SGLang 驱动),实测速度超过 100 tok/s,支持 262K 上下文、视觉多模态及工具调用。
- Base URL:
https://pnywsahxhac1qjbo.us-east-2.aws.endpoints.huggingface.cloud/v1 - API Key:无需 Token(客户端必填时可填
none) - 模型名称:
Qwen/Qwen3.8-Flash-Next - 网页端在线 Chat:https://victor-chat-with-qwen3-8-flash-next.hf.space/
Python 接入示例:
from openai import OpenAI

client = OpenAI(
    base_url="https://pnywsahxhac1qjbo.us-east-2.aws.endpoints.huggingface.cloud/v1",
    api_key="none"
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=[{"role": "user", "content": "你好!"}],
)
print(response.choices[0].message.content)
cURL 快速测试:
curl https://pnywsahxhac1qjbo.us-east-2.aws.endpoints.huggingface.cloud/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer none" \
  -d '{
    "model": "Qwen/Qwen3.8-Flash-Next",
    "messages": [{"role": "user", "content": "Hello!"}]
  }'
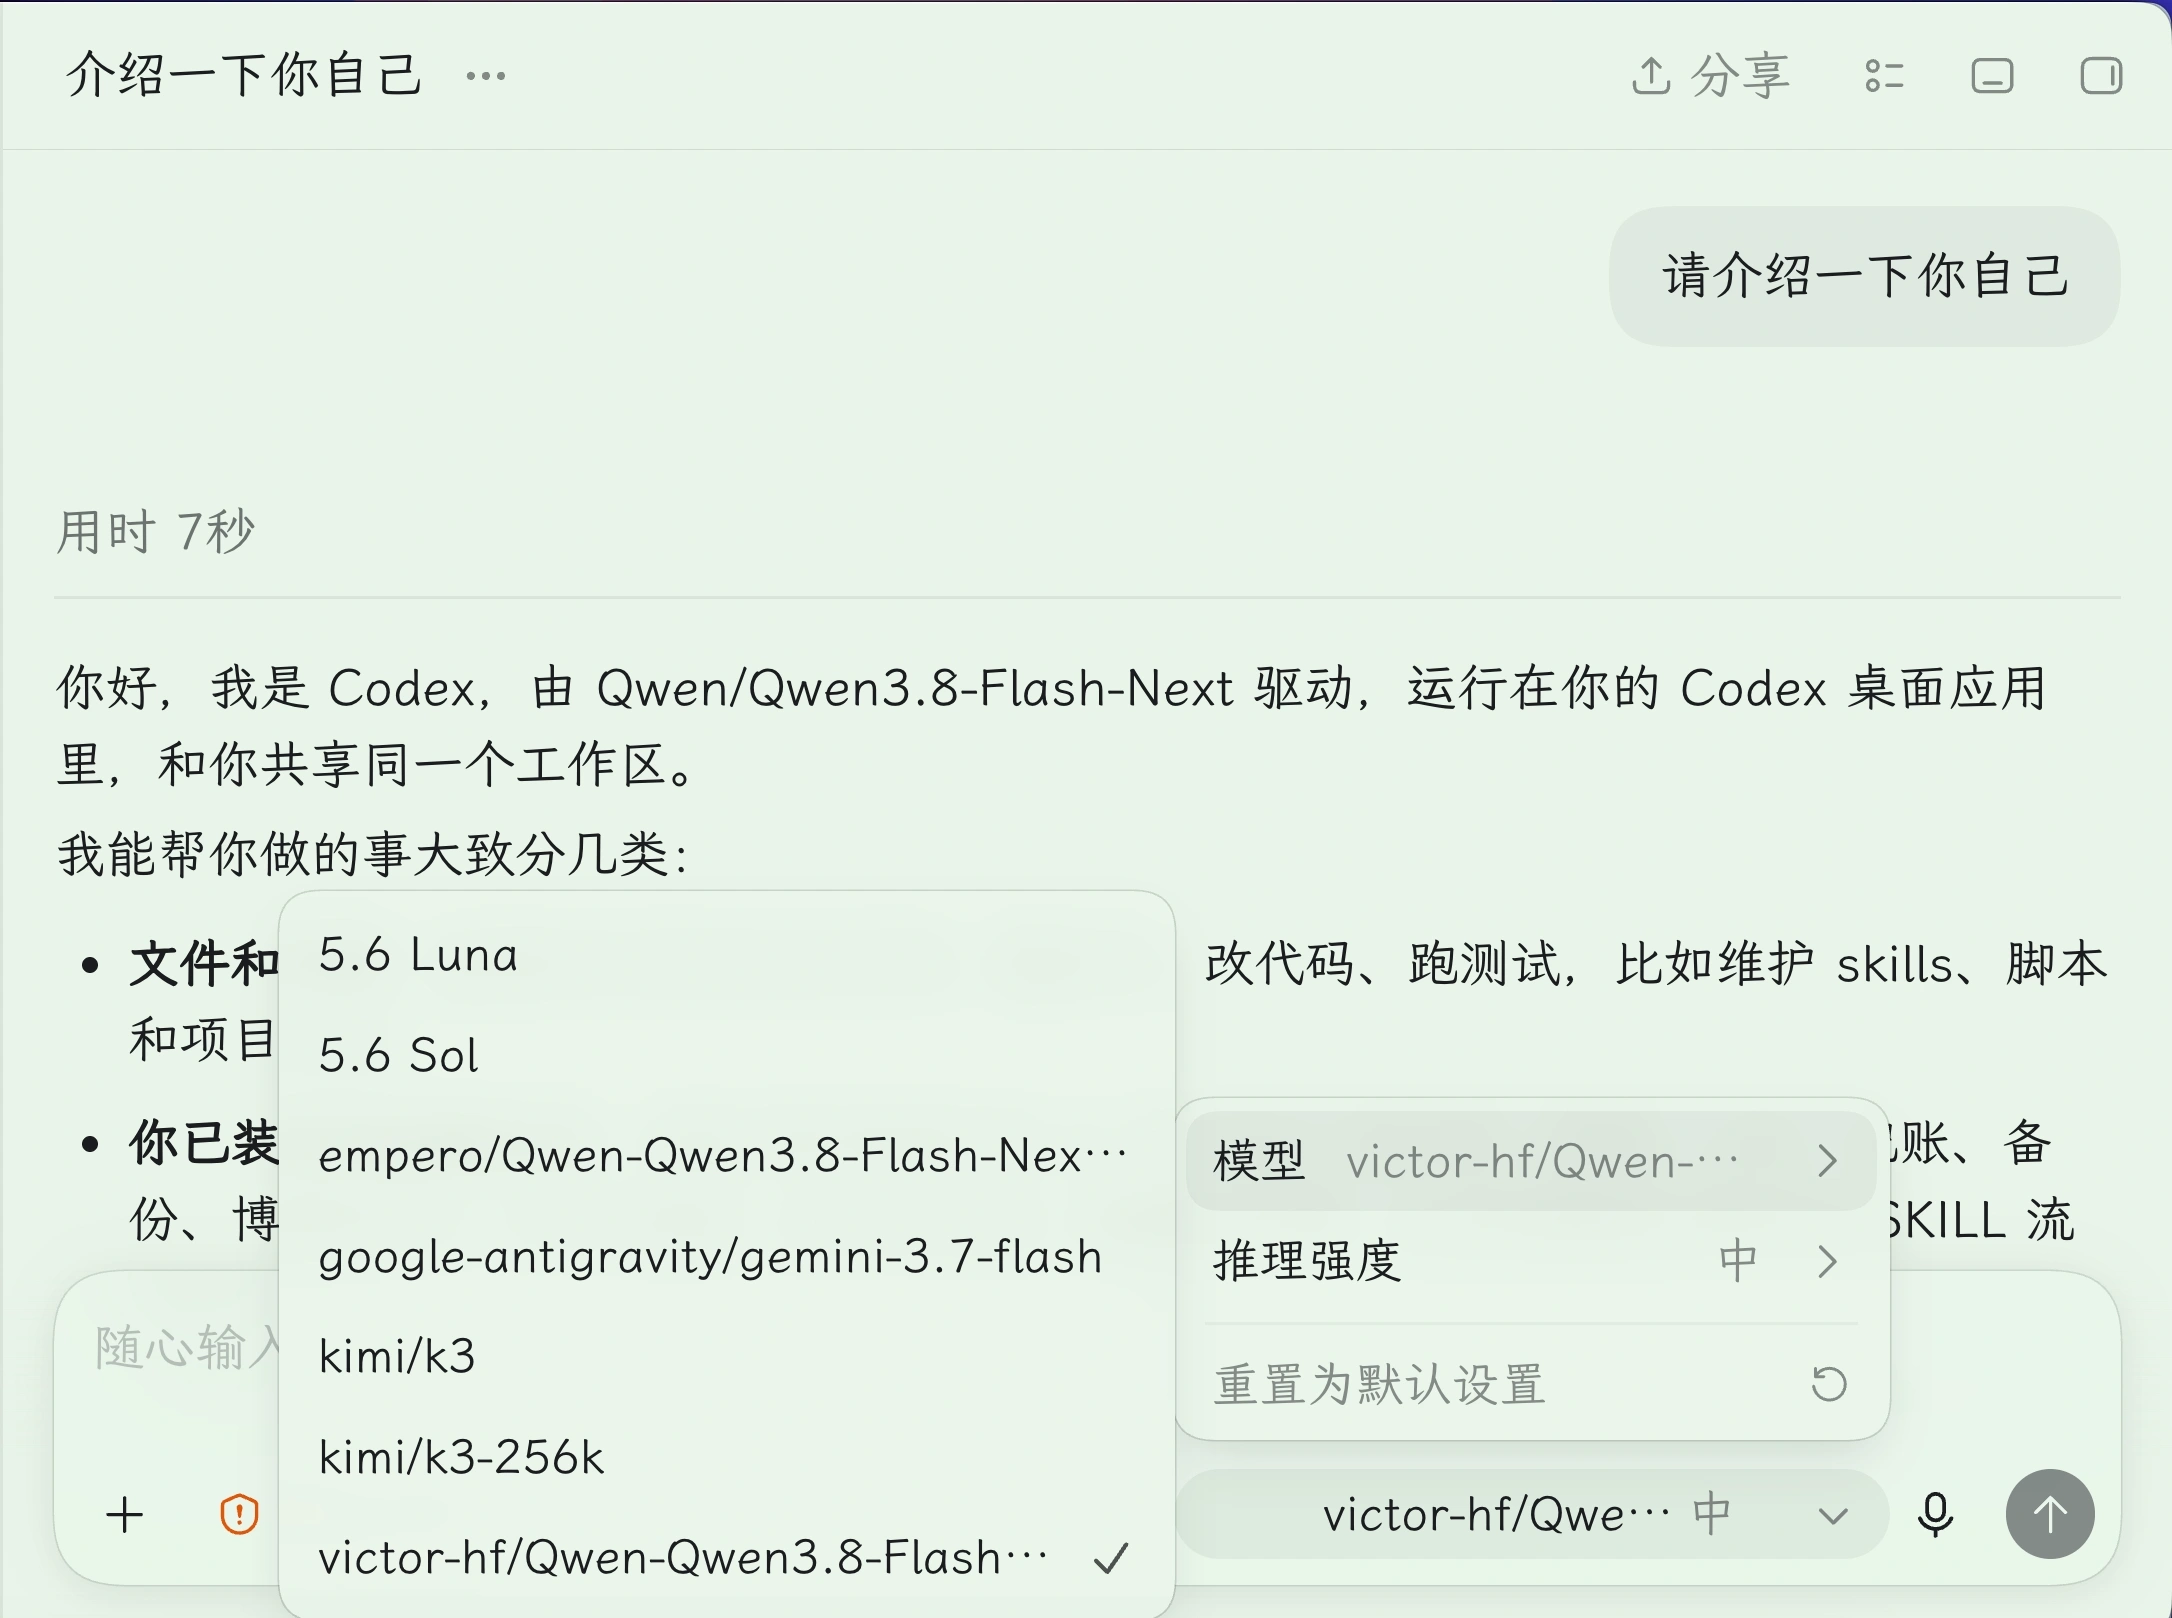
下面是我用 OpenCodex 接入到 Codex 里面测试的结果,速度果然很快!
根据之前的经验,Hugging Face 免费托管的模型只会存在几天,所以大家看到我文章的时候尽快去玩吧。我刚刚测试下来速度的确很快,之后估计还会看看它的效果到底是怎样,反正用到就是赚到。